Jetson Orin Nano 實戰(二):用 TensorRT 讓 YOLOv8 推論快 4.8 倍
上一篇〈實戰(一)〉已經讓 Jetson Orin Nano 用 PyTorch GPU 跑 YOLOv8n,推論約 17 ms、畫面約 30 FPS。這篇要把模型轉成 NVIDIA 的 TensorRT engine,再用一支專門跑 TensorRT 的 server01.py 執行。
實測結果:推論時間從 17.4 ms 降到 3.6 ms,約快 4.8 倍,偵測結果幾乎一樣。
匯出 TensorRT 的過程有幾個地方很容易讓人以為「當掉了」或「裝不起來」。以下照正確順序寫,第一次就能成功。
前置條件
- 已完成〈實戰(一)〉:相機正常、
torch.cuda.is_available()為True、server.py能夠執行。 - 本文環境:Jetson Orin Nano 8GB(Super)、JetPack 6.2(TensorRT 10.3.0)、Python 3.10、IMX219 相機。
先看重點:三個最容易走錯的地方
- 先手動裝好 ONNX 相關套件:PyPI 上沒有 Jetson 版的
onnxruntime-gpu。如果讓 ultralytics 在匯出時自動安裝,整批安裝會失敗,連onnx都沒裝上。→ 步驟 1 - 匯出時有好幾分鐘沒有任何輸出,這是正常的:不要以為當掉就中斷它;另外要先開全速,並釋放記憶體。→ 步驟 2、3
- 確認跑的真的是 TensorRT:
server.py找不到 engine 時,會默默改用.pt。所以這篇用只載入 engine 的server01.py。→ 步驟 4
步驟 1:安裝 ONNX 相關套件(匯出前先裝)
1 | pip3 install onnx onnxslim "numpy<2" |
onnxruntime-gpu的 Jetson 版 wheel 取自 Ultralytics 官方 Jetson 指南。安裝 onnx 時 numpy 可能被升級,所以一起加上"numpy<2"。
確認四個套件都正常:
1 | python3 -c "import numpy; print('numpy', numpy.__version__)" |
| 檢查項目 | 應該看到 |
|---|---|
| numpy | 1 開頭(例如 1.26.4) |
| cv2 | GStreamer: YES |
| torch | CUDA True |
| onnxruntime | providers 裡有 TensorrtExecutionProvider 與 CUDAExecutionProvider |
步驟 2:匯出前的準備:開全速、釋放記憶體
1 | cd ~/yolo_project |
Orin Nano 的 8 GB 記憶體由 CPU 與 GPU 共用。匯出時 TensorRT 需要不少記憶體,請先關掉其他程式。
步驟 3:匯出 TensorRT engine
1 | yolo export model=yolov8n.pt format=engine half=True imgsz=640 device=0 workspace=2 |
| 參數 | 意義 |
|---|---|
format=engine |
輸出 TensorRT engine |
half=True |
使用 FP16(半精度) |
imgsz=640 |
輸入尺寸;之後推論時必須用同樣的尺寸 |
workspace=2 |
限制建構時使用的記憶體(GB),避免 8 GB 機器記憶體不足 |
停住不動時,不要中斷它
輸出 building FP16 engine as yolov8n.engine 之後,畫面會有好幾分鐘完全沒有新訊息。我實測花了 392 秒(約 6.5 分鐘)。這段時間 TensorRT 正在為這台機器挑選最快的運算方式。
想確認它還在跑,可以另開一個終端機:
1 | sudo tegrastats --interval 2000 |
在輸出中找 GR3D_FREQ 這個欄位(GPU 使用率):
| 看到的情況 | 判斷 |
|---|---|
GR3D_FREQ 時常有數值(例如 20%~40%) |
正在建構,繼續等 |
GR3D_FREQ 方括號裡的時脈只有 @[305] 左右 |
jetson_clocks 沒有生效,執行 sudo jetson_clocks(匯出中執行也安全) |
RAM 接近滿載,SWAP 一直增加 |
記憶體不足,中止後改用 workspace=1 重做 |
超過 20 分鐘,GR3D_FREQ 一直是 0% |
真的卡住了,按 Ctrl + C 中止後重做 |
注意:
GR3D_FREQ是輸出裡的欄位名稱,不是指令的一部分。指令只要打sudo tegrastats --interval 2000;看完按Ctrl + C離開,不會影響匯出。
完成畫面
1 | Export complete (392.1s) |
確認檔案大小:
1 | ls -lh yolov8n.engine # 約 9 MB |
engine 檔和這台機器的 GPU 與 TensorRT 版本綁定。換機器或升級 JetPack 後,要重新匯出。
步驟 4:建立 server01.py(TensorRT 專用版)
server01.py 是以上一篇的 server.py 為基礎修改的,差別在於:
- 只載入
.engine:找不到 engine,或檔案小於 1 MB(匯出中斷時留下的半成品),就直接停止並印出匯出指令,不會默默改用.pt。 - 啟動前先暖機 3 次:TensorRT 前幾次推論會花時間配置記憶體,先跑掉再開始計時,數字比較準。
- 畫面標示
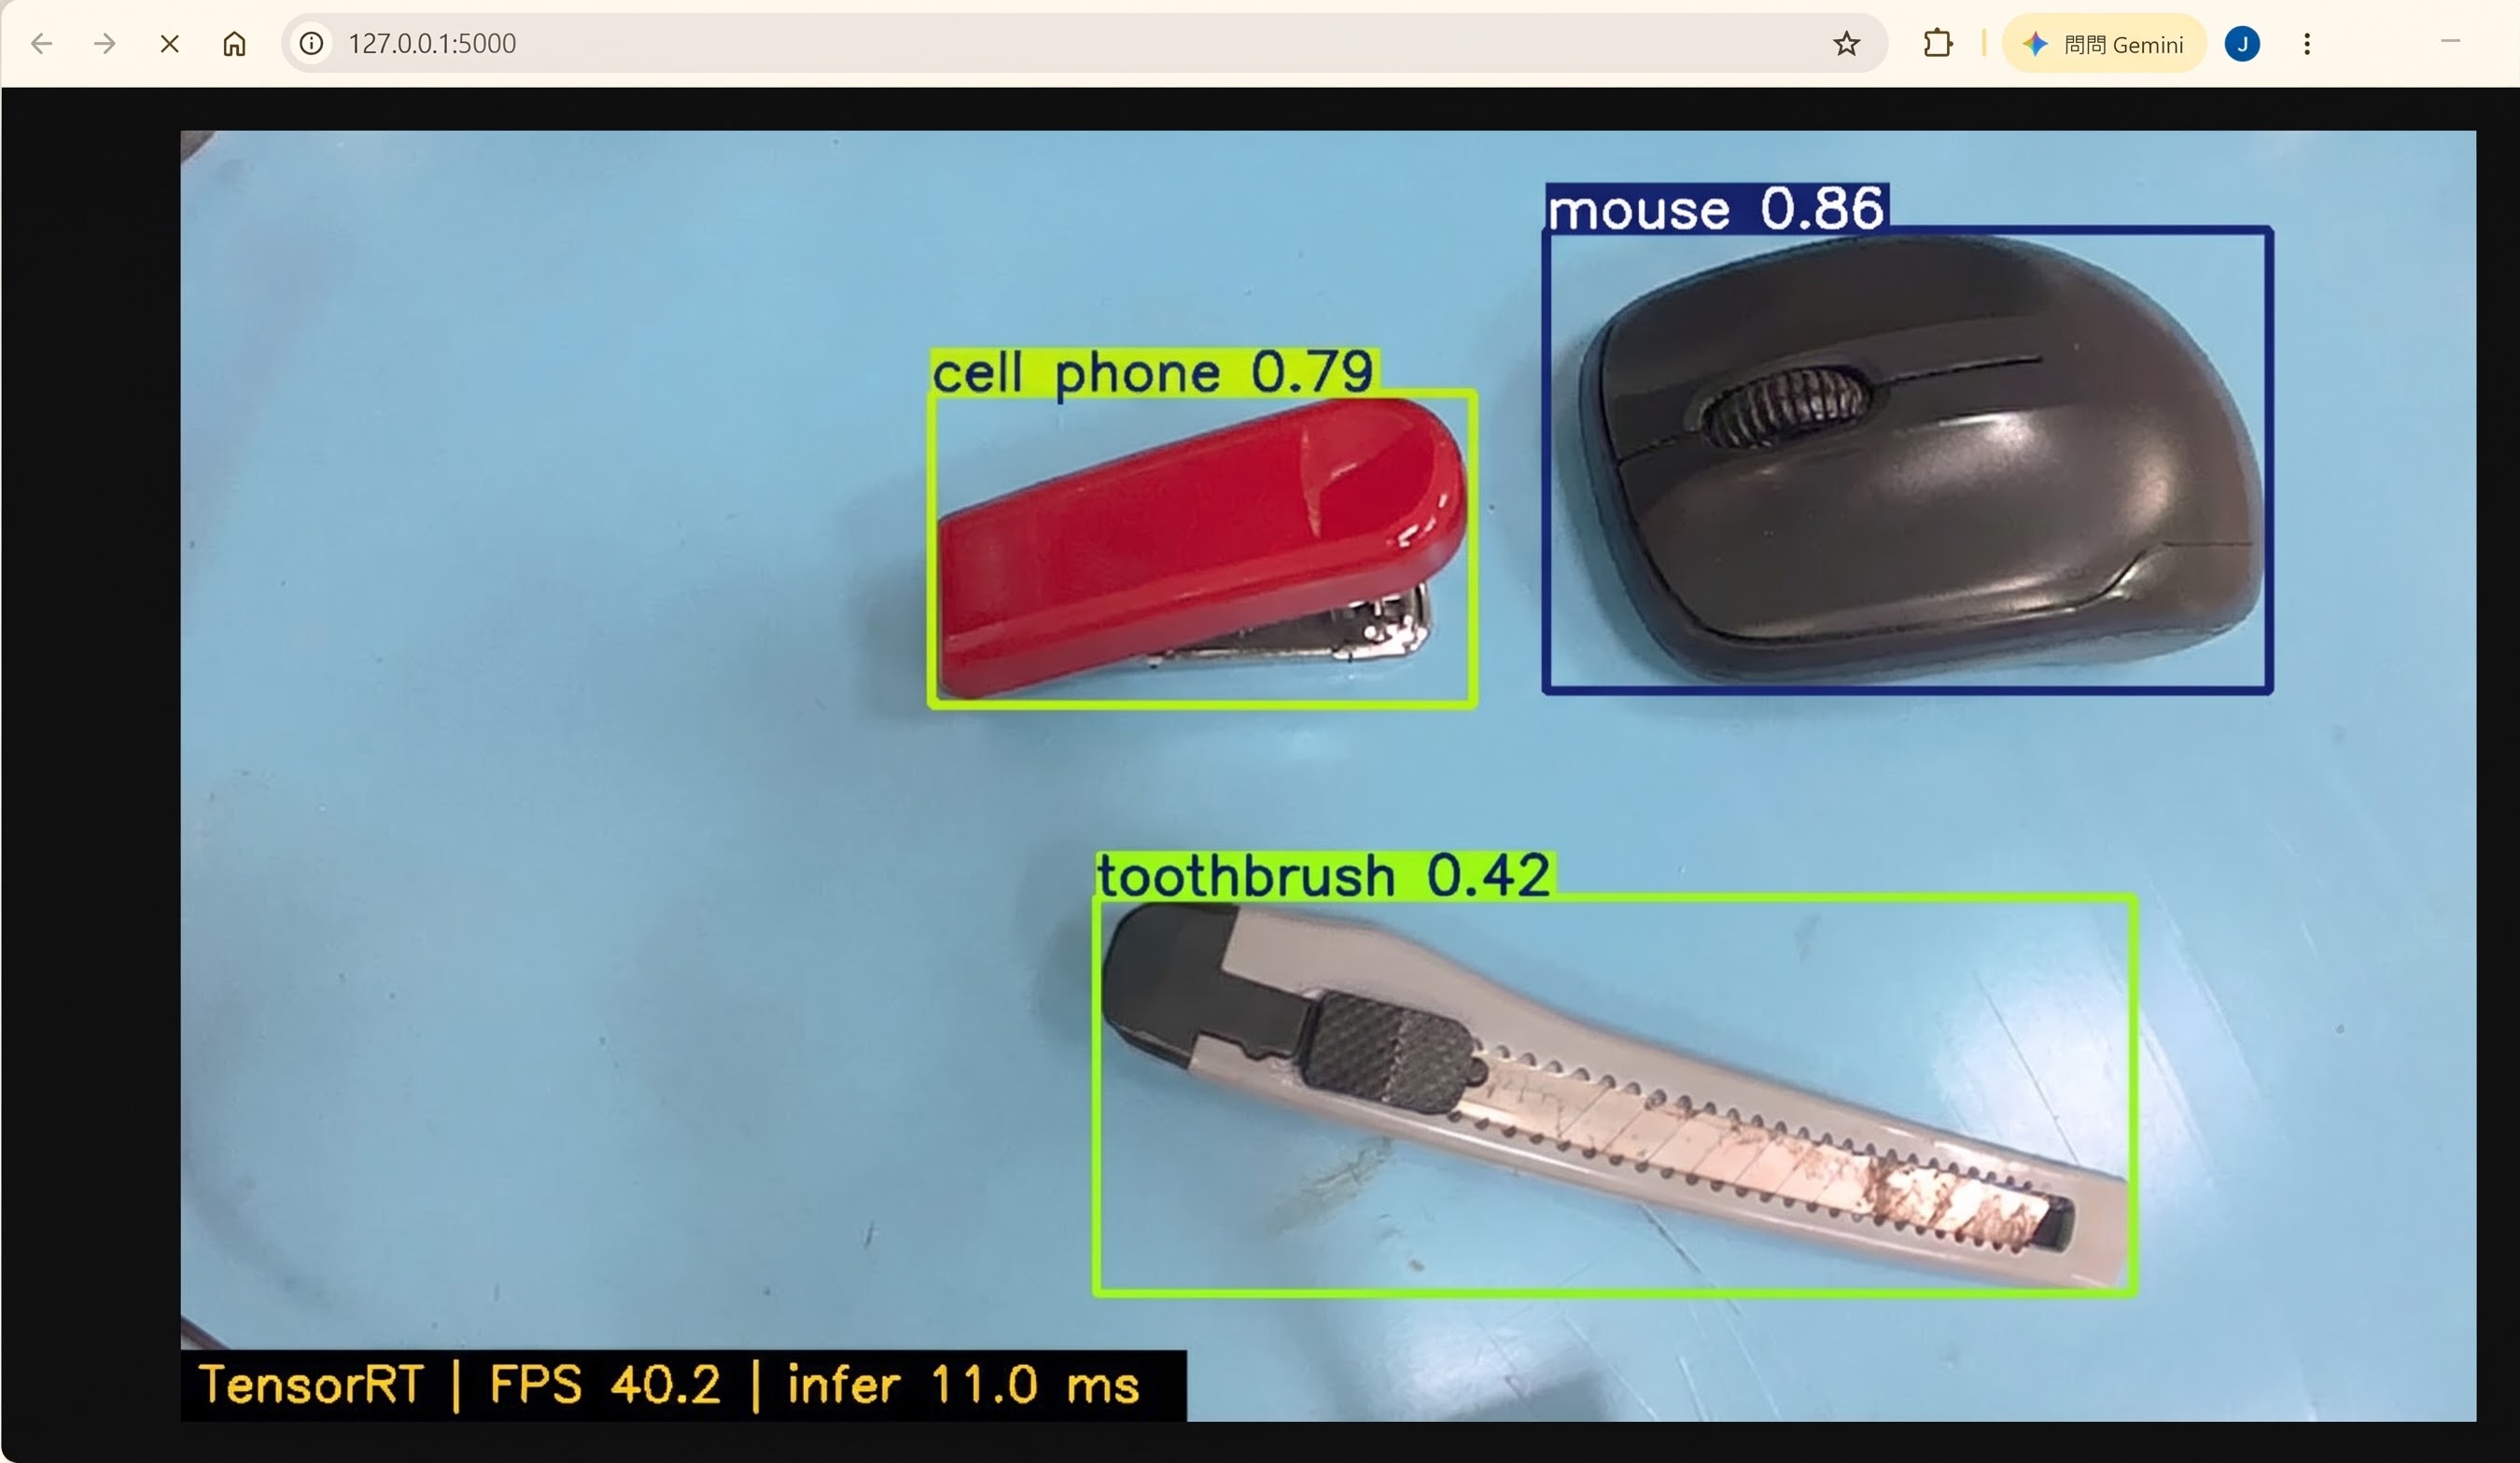
TensorRT:左下角以橘色字顯示TensorRT | FPS … | infer … ms,推論時間取移動平均。 - 可以用
IMGSZ環境變數指定推論尺寸,必須和匯出時的imgsz相同(預設 640)。
一樣建議用 VS Code Remote-SSH 或 scp 放到 ~/yolo_project/,不要直接貼進終端機。
完整程式碼
1 | """TensorRT 版 YOLO 串流:只載入 .engine,不會自動退回 .pt。""" |
步驟 5:執行並比較
1 | cd ~/yolo_project |
成功時會依序看到:
1 | 正在載入 TensorRT engine:yolov8n.engine |
實測比較(Orin Nano 8GB Super,1280×720,imgsz 640)
| 項目 | PyTorch GPU(server.py) | TensorRT FP16(server01.py) |
|---|---|---|
| 推論時間 | 17.4 ms | 3.6 ms(約快 4.8 倍) |
| 處理迴圈 FPS | 約 30 | 約 40 |
| 偵測結果(同一場景) | person 0.88 | person 0.82 |
| 匯出時間/engine 大小 | — | 392 秒/9.0 MB |
處理迴圈可以超過 30 FPS,是因為 IMX219 的 1280×720 模式最高支援 60 fps。用上 TensorRT 後,推論只占每張畫面處理時間的一小部分,瓶頸變成讀取相機、畫偵測框與 JPEG 編碼。
為什麼 TensorRT 快這麼多?
TensorRT 不是讓模型少算一點,而是事先針對這一台 Jetson 的 GPU,把整個模型重新編譯成最佳化的執行計畫:
- 層融合:把「卷積 → BatchNorm → 激活函數」合併成一次 GPU 運算,減少記憶體來回搬運。
- 省去逐層下指令的開銷:PyTorch 每執行一層,CPU 都要透過 Python 通知 GPU;YOLOv8n 這種小模型,這段開銷占比很高。TensorRT 的執行計畫是固定的,幾乎沒有這段開銷。
- 自動調校:匯出那幾分鐘,TensorRT 會在這台機器上實測每一層的各種實作方式,選出最快的。這也是 engine 只能在同一台機器上使用的原因。
- 固定輸入尺寸:記憶體可以事先規劃好、重複使用。
FP16 其實不是主因:上一篇的
server.py也加了half=True,PyTorch 那邊本來就用半精度。
實務建議:開發、調整階段用 .pt(server.py),修改比較方便;正式部署時改用 TensorRT(server01.py),追求速度。
如果還是遇到問題
| 症狀 | 原因與處理 |
|---|---|
No matching distribution found for onnxruntime-gpu,接著出現 No module named 'onnx' |
沒有先做步驟 1 → 手動安裝後再匯出 |
numpy.core.multiarray failed to import |
安裝 onnx 時 numpy 被升級 → pip3 install "numpy<2" |
匯出時出現 NvMapMemAllocInternalTagged: ... error 12 |
記憶體不足 → 停掉其他程式,改用 workspace=1 |
server01.py 顯示找不到可用的 engine |
匯出沒完成,或檔案不完整 → 重新匯出,確認約 9 MB |
無法從相機取得畫面 |
server.py 還在執行 → pkill -f server.py |
Failed to create CaptureSession |
前一支程式沒有正常釋放相機 → sudo systemctl restart nvargus-daemon |
結語
兩篇做下來,一台 Jetson Orin Nano 就能以 3.6 ms 的推論速度即時偵測物件,GPU 還留有大量餘裕:可以換用更準確的 yolov8s、同時接兩顆相機,或者降低功耗模式來省電。
PS: 這是後來擷取的影像,FPS和推論時間都略有不同。關於YOLO辨識的正確度也要再找時間研究一下改善的方法。